// ТЕХНИЧЕСКИЕ РАЗБОРЫ · 82 СТАТЕЙ
БЛОГ REDDYX AI
Конкретные технические разборы AI/ML/Web3 инструментов. Примеры кода, бенчмарки, без маркетинговой воды.
 Инфраструктура
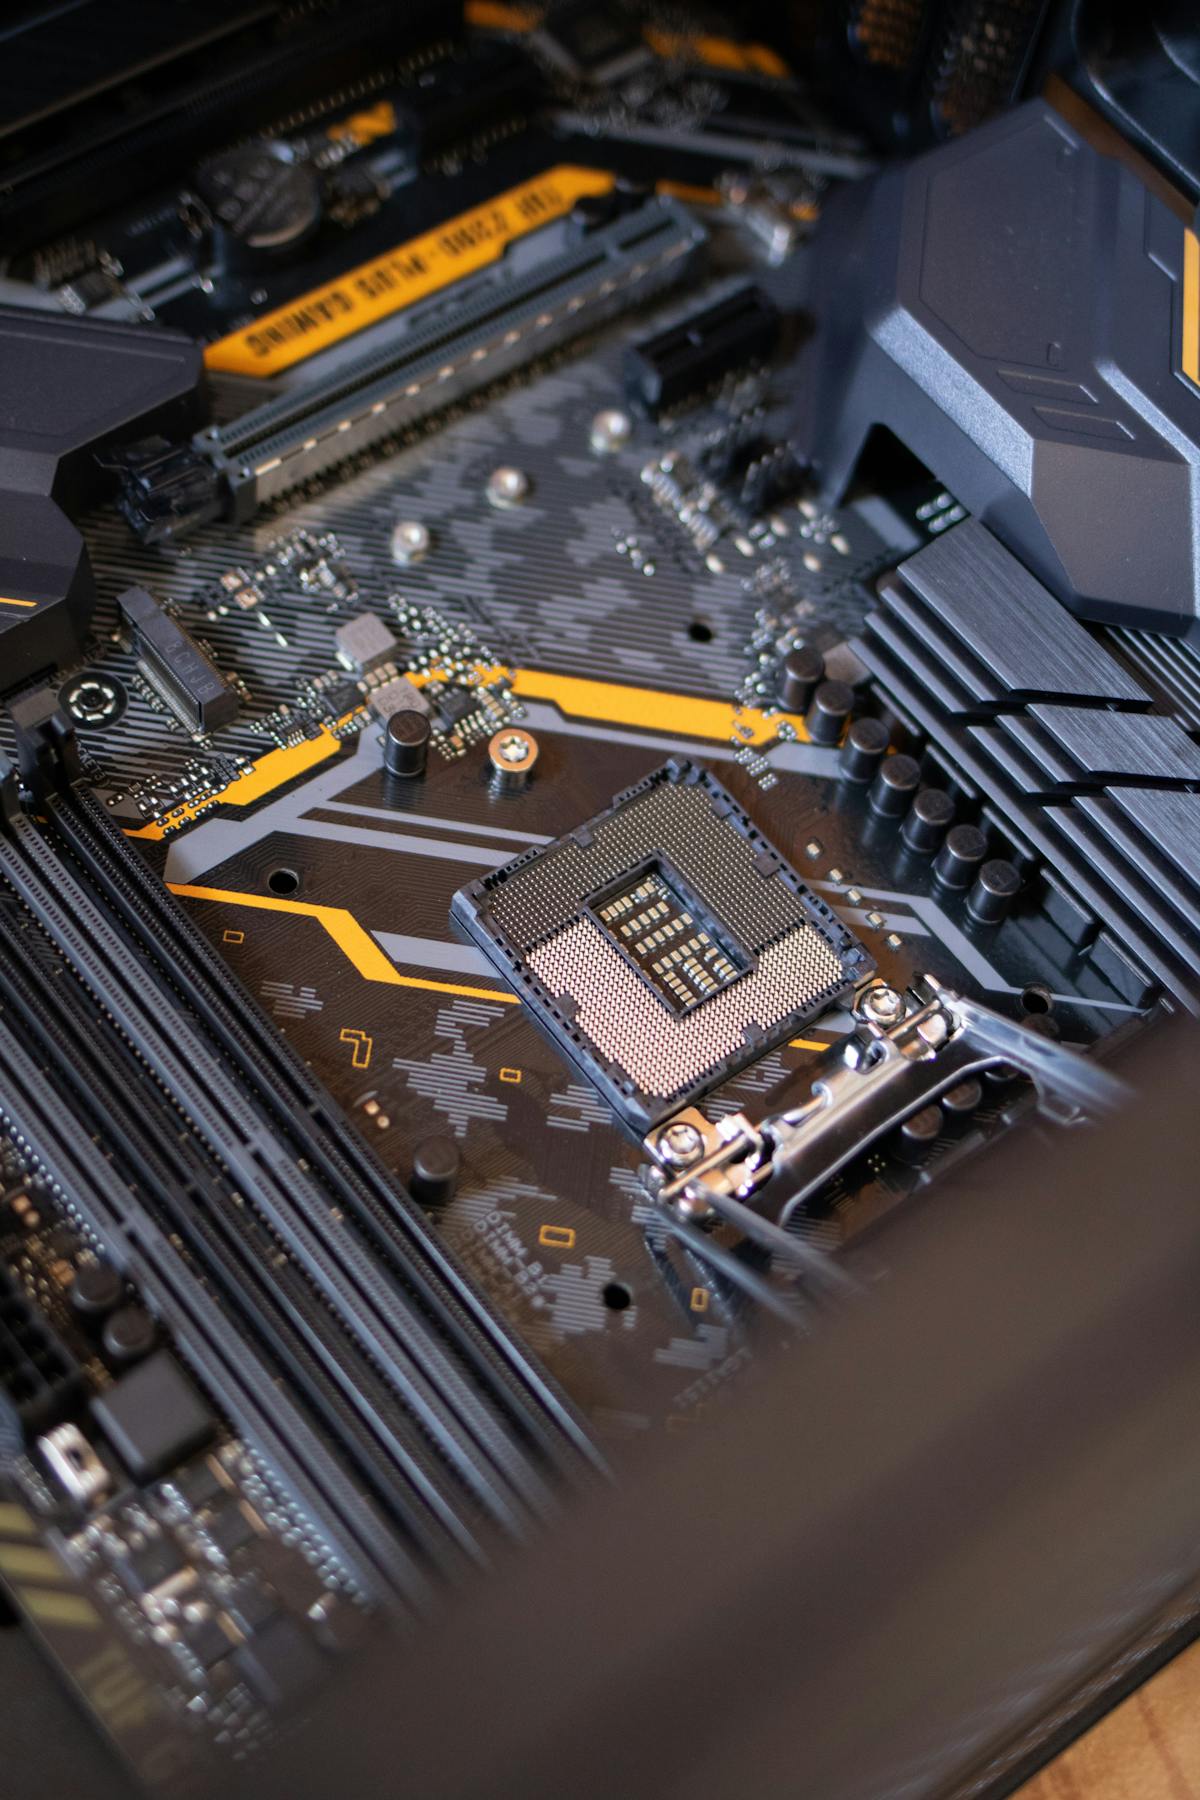
Сколько VRAM нужно для LLM в 2026: считаем до скачивания модели
Формула расчёта VRAM под LLM в 2026: параметры, квантизация, KV-кэш и контекст. Таблицы по GGUF Q4/Q8, что влезет на 8/12/24/48 ГБ и как ужать модель без потери качества.
 Инфраструктура
Мониторинг LLM в продакшене 2026: Langfuse, Helicone и другие инструменты observability
LLM observability и мониторинг в продакшене 2026: сравнение Langfuse, Helicone, трейсинг запросов, метрики токенов и стоимости. Практический гайд для разработчиков.
 Инфраструктура
Где арендовать GPU для ML в 2026: сравнение цен и скорости
Аренда GPU для ML в 2026: где взять H100 дешевле, реальные цены на облако, скорость обучения модели и сравнение провайдеров. Гайд практика с таблицами и кодом.
 Инфраструктура
Ускорение инференса в 2026: ONNX, TensorRT и vLLM на практике
Как ускорить инференс в 2026: ONNX, TensorRT и vLLM на практике. Разбор оптимизации латентности и throughput, реальные цифры, код и таблица сравнения.
 Инфраструктура
Edge AI в 2026: запускаем нейросеть прямо на телефоне
Edge AI в 2026: как запустить LLM и инференс на устройстве без облака. Разбираем движки, приватность, замеры на телефоне и рабочий код для мобильного.
 Инфраструктура
vLLM против TGI: что быстрее для продакшн-инференса LLM
Бенчмарк vLLM 0.6 против Text Generation Inference на A100. Throughput, P99 latency, memory efficiency. Конфигурация под продакшн нагрузку.
 Инфраструктура
Кэширование LLM в 2026: как сократить счёт за API в 10 раз
Prompt caching и оптимизация стоимости LLM: множители записи 1.25x/2x, чтение 0.1x, TTL, cache_control и чек-лист тихих убийц кэша. Экономия до 10x на API.